1,250,964건의 감사 행렬 기록, 아무 일도 없었다는 내용
(dev.to)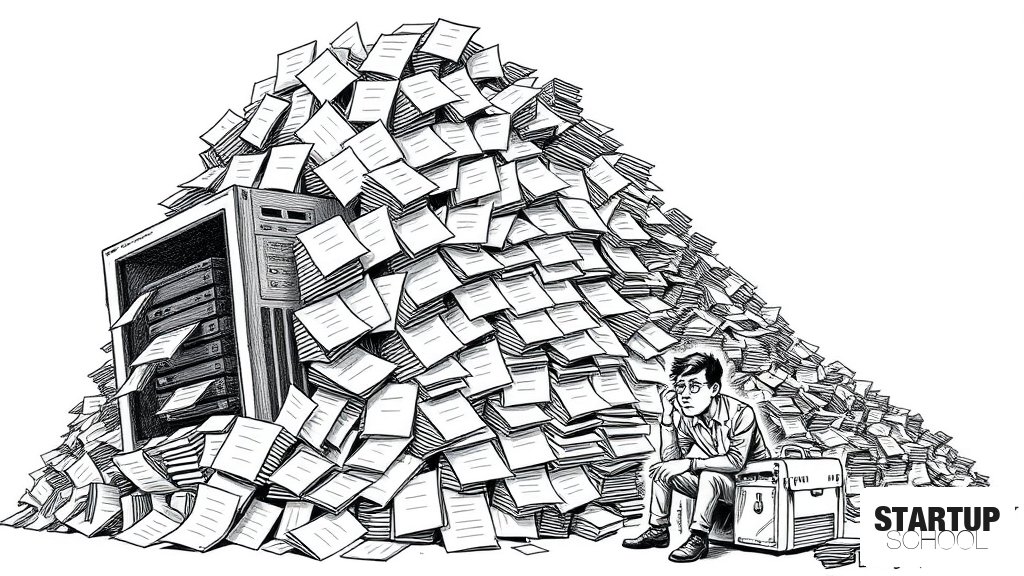
반복되는 배치 작업이 데이터의 변화가 없는 '상태'를 새로운 '이벤트'로 오인해 기록할 경우, 데이터베이스 용량을 급격히 점유하여 시스템 장애를 유발할 수 있다는 설계적 오류를 다룹니다.
이 글의 핵심 포인트
- 1125만 건의 '스킵' 로그가 5만 건의 실제 결정 로그보다 약 24배 더 많이 기록됨
- 2원인은 15분마다 실행되는 배치 작업이 변하지 않는 상태를 매번 새로운 이벤트로 기록한 멱등성 결여
- 3로그 테이블의 크기가 사용자 데이터가 아닌 스케줄링 주기에 의해 결정되는 구조적 결함 발생
- 4해결을 위해 '스킵' 로그 기록을 중단하고, 배치 단위 삭제(Batch Delete)와 VACUUM FULL을 통해 디스크 공간을 재확보함
- 5삭제 시 한 번에 대량의 트랜잭션을 처리하기보다 배치로 나누어 처리하는 것이 WAL(Write Ahead Log) 관리에 필수적임
이 글에 대한 공공지능 분석
왜 중요한가?
단순한 코드 버그가 아닌, 시스템의 '멱등성(Idempotency)' 결여가 어떻게 인프라 비용과 서비스 안정성을 파괴할 수 있는지 보여주는 결정적인 사례이기 때문입니다.
어떤 배경과 맥락이 있나?
클라우드 기반의 관리형 데이터베이스(Managed DB) 환경에서는 저장 용량 쿼터가 엄 엄격하게 제한되어 있어, 비효율적인 로그 누적이 즉각적인 서비스 중단과 비용 상승으로 이어질 수 있습니다.
업계에 어떤 영향을 주나?
개발자는 로그를 설계할 때 '발생한 사건(Event)'과 '유지되는 상태(State)'를 엄격히 구분해야 하며, 주기적 작업(Cron job)의 쓰기 로직이 데이터의 양이 아닌 스케줄링 주기에 종속되지 않도록 설계해야 합니다.
한국 시장에 어떤 시사점이 있나?
빠른 성장을 지향하며 관리형 서비스를 적극 활용하는 한국 스타트업들에게, 인프라 비용 최적화와 안정적인 운영을 위해 배치 작업의 데이터 생성 패턴을 주기적으로 점검하는 것이 필수적임을 시사합니다.
이 글에 대한 큐레이터 의견
이 사례는 '정확한 로직'이 반드시 '안정적인 시스템'을 보장하지 않는다는 점을 시사합니다. 개발자는 기능적 요구사항을 넘어, 시스템의 확장성과 인프라의 물리적 한계를 고려한 '비용 효율적 설계'를 고민해야 합니다.
다만, 모든 '스킵' 로그를 삭제하는 것은 디버깅 관점에서 리스크가 될 수 있습니다. 무엇이 왜 처리되지 않았는지에 대한 가시성(Observability)을 잃을 위험이 있기 때문입니다. 따라서 단순히 삭제하는 것에 그치지 않고, 상태 변화가 있을 때만 기록하거나 주기적인 요약 로그를 남기는 식의 트레이드오프를 고려한 대안이 필요합니다.
스타트업 창업자라면 개발 팀이 작성한 자동화 스크립트가 데이터의 양이 아닌 '실행 횟수'에 따라 인프라 비용을 폭증시키고 있지는 않은지 검토할 수 있는 모니터링 체계를 갖춰야 합니다.
관련 뉴스
댓글
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.