로그 vs 지수: O(log n)과 O(2ⁿ)의 간단한 아이디어
(dev.to)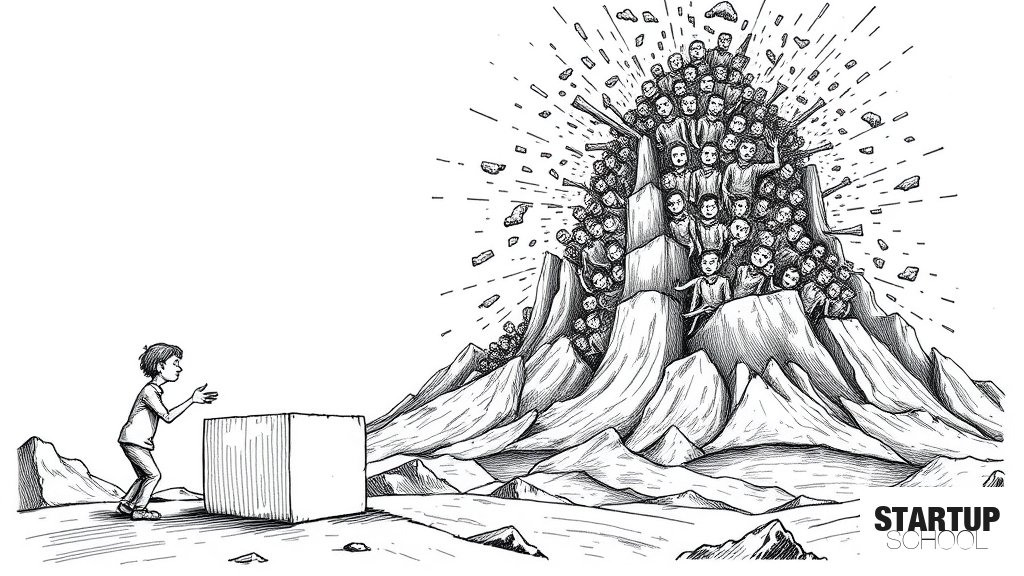
알고리즘 효율성을 결정하는 핵심 지표인 로그($O( ext{log } n)$)와 지수($O(2^n)$) 복잡도를 '나누기'와 '곱하기'라는 직관적인 개념으로 설명하여 개발자가 복잡한 수식 없이도 문제의 효율성을 판단할 수 있는 통찰을 제공합니다.
이 글의 핵심 포인트
- 1로그($O(\log n)$)는 문제를 반복적으로 나누는(Halving) 과정으로 이해할 수 있음
- 2지수($O(2^n)$)는 선택지가 기하급수적으로 늘어나는(Branching) 과정으로 이해할 수 있음
- 3이진 탐색(Binary Search)은 문제를 절반씩 줄여나가기 때문에 $O(\log n)$의 효율성을 가짐
- 4부분 집합(Subsets)이나 백트래킹(Backtracking) 문제는 각 단계에서 선택지가 늘어나 $O(2^n)$의 복잡도를 가짐
- 5데이터 규모($n$)가 커질 때 로그 복잡도는 매우 느리게 증가하지만, 지수 복잡도는 매우 빠르게 증가함
이 글에 대한 공공지능 분석
왜 중요한가?
알고리즘의 시간 복잡도를 정확히 이해하는 것은 서비스의 확장성(Scalability)을 결정짓는 기초 체력입니다. 효율적인 알고리즘 설계는 데이터 규모가 커질 때 시스템 붕괴를 막고 운영 비용을 최적화하는 핵심 요소입니다.
어떤 배경과 맥락이 있나?
데이터 규모가 폭증하는 현대 IT 환경에서 $O(n)$ 이상의 복잡도를 가진 로직은 치명적인 병목을 초래합니다. 개발자는 코드의 동작을 넘어 연산량의 증가 패턴을 예측하고, 이를 통해 인프라 자원 사용량을 설계할 수 있어야 합니다.
업계에 어떤 영향을 주나?
효율적인 알고리즘(Logarithmic)은 클라우드 컴퓨팅 비용 절감과 직결되며, 비효율적인 알고리즘(Exponential)은 서비스 장애의 주범이 됩니다. 이는 기술적 우위가 곧 기업의 비용 경쟁력으로 이어지는 클라우드 네이티브 시대에 매우 중요한 역량입니다.
한국 시장에 어떤 시사점이 있나?
글로벌 시장을 타겟으로 대규모 트래픽을 처리해야 하는 한국 스타트업에게 알고리즘 최적화는 선택이 아닌 필수입니다. 단순 기능 구현을 넘어, 데이터 증가에 따른 비용 효율적 아키텍처를 설계할 수 있는 엔지니어링 역량이 기업의 생존을 결정할 것입니다.
이 글에 대한 큐레이터 의견
개발자에게 알고리즘 복잡도에 대한 직관적 모델을 제공하는 것은 매우 가치 있는 일입니다. 특히 '나누기'와 '곱하기'라는 단순한 프레맥워크는 복잡한 수학적 정의에 매몰되지 않고 코드의 잠재적 위험성을 빠르게 감지하게 돕습니다. 이는 초기 스타트업이 기술 부채를 관리하고 확장 가능한 제품을 만드는 데 실질적인 도움을 줍니다.
하지만 이러한 직관적 이해만으로는 부족할 수 있습니다. 실제 복잡한 시스템에서는 단순한 $O(\log n)$이나 $O(2^n)$을 넘어, 상수항(constant factor)이나 메모리 계층 구조(cache locality) 등 알고리즘의 실제 성능에 영향을 미치는 변수가 매우 많기 때문입니다. 따라서 직관으로 패턴을 파악하되, 정밀한 프로파일링을 통해 검증하는 습관이 병행되어야 합니다.
창업자는 팀의 개발 역량이 단순 구현을 넘어 이러한 비용 효율적 사고로 확장될 수 있도록 기술적 가이드라인을 제시해야 합니다. 알고리즘의 효율성이 곧 비즈니스의 마진율과 직결된다는 인식을 심어주는 것이 중요합니다.
관련 뉴스
댓글
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.