Google, 유럽 내 검색 데이터 라이선스 대상 명시
(searchenginejournal.com)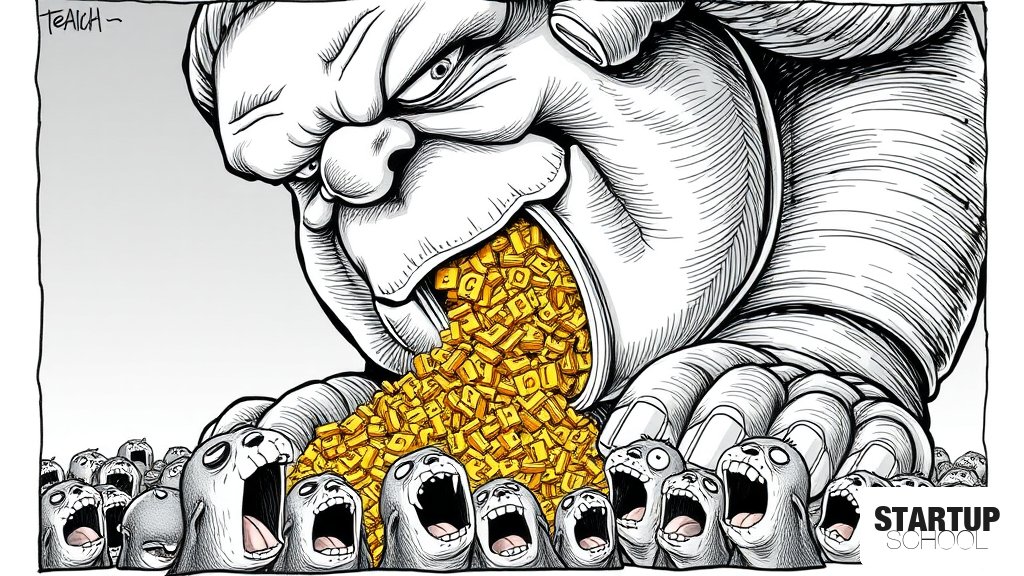
구글이 유럽 디지털 시장법(DMA)에 따라 경쟁 검색 엔진 및 AI 챗봇에 검색 데이터를 제공하기 위한 구체적인 라이선스 절차와 일정을 공개하며, 이는 검색 데이터 생태계의 재편과 AI 모델의 성능 고도화 기회를 시사합니다.
이 글의 핵심 포인트
- 1구글은 유럽 경제 지역(EEA) 내 검색 랭킹, 쿼리, 클릭 및 뷰 데이터를 라이선스 방식으로 제공할 예정입니다.
- 2신청 자격은 EU 내 월평균 5만 명 이상의 사용자를 보유하거나, 최근 진입자의 경우 5,000만 유로 이상의 자본 투자를 받은 기업으로 제한됩니다.
- 3데이터 샘플은 11월 16일부터 제공되며, 무료 샘플(1,000행)과 유료 합성 데이터셋(최대 1,000만 쿼리) 등이 포함됩니다.
- 45% 샘플 및 전체 데이터셋 접근을 위해서는 기술적 설정과 데이터 보호 체계를 검증하는 독립적인 감사(Audit)를 통과해야 합니다.
- 5라이선스 비용은 데이터 제공에 드는 증분 비용과 특정 수익률을 포함한 공정하고 합리적이며 비차별적인(FRAND) 조건으로 책정됩니다.
이 글에 대한 공공지능 분석
왜 중요한가?
구글이 독점해온 방대한 검색 데이터를 경쟁사들이 합법적으로 이용할 수 있게 됨으로써, 검색 엔진 시장의 데이터 불균형이 완화되고 AI 기반 검색 서비스의 경쟁력이 급격히 상승할 수 있습니다.
어떤 배경과 맥락이 있나?
유럽연합(EU)의 디지털 시장법(DMA)은 거대 플랫폼의 데이터 독점을 막기 위해 구글과 같은 게이트키퍼에게 데이터 공유 의무를 부과했으며, 이번 발표는 그 실행을 위한 구체적인 로드맵을 제시합니다.
업계에 어떤 영향을 주나?
특히 높은 수준의 검색 데이터를 필요로 하는 AI 챗봇 스타트업들에게는 모델의 정확도와 사용자 경험을 개선할 수 있는 강력한 기회가 될 것이며, 이는 차세대 검색 엔진 개발의 촉매제가 될 수 있습니다.
한국 시장에 어떤 시사점이 있나?
글로벌 시장 진출을 노리는 한국의 AI 및 검색 기술 스타트업들은 유럽의 규제 환경을 활용해 구글의 데이터를 학습 및 서비스 고도화에 활용할 수 있는 전략적 접근이 필요합니다.
이 글에 대한 큐레이터 의견
이번 구글의 데이터 라이선스 공개는 AI 검색 시대의 '데이터 민주화'를 가속화할 중요한 변곡점입니다. 구글의 데이터를 활용해 검색 품질을 빠르게 높일 수 있다는 점은 신규 진입자들에게 엄청난 기회이지만, 동시에 데이터 활용에 따른 막대한 감사 비용과 엄격한 데이터 보호 규제 준수라는 높은 컴플라이언스 비용(Compliance Cost)을 수반한다는 점을 간과해서는 안 됩니다.
스타트업 창업자들은 단순히 데이터 확보에만 매몰될 것이 아니라, 제공되는 데이터의 품질과 자사의 기술적 역량을 결합해 어떻게 차별화된 사용자 경험을 만들 것인지 고민해야 합니다. 또한, 데이터 활용 과정에서 발생할 수 있는 개인정보 보호 이슈와 지속적인 감사 의무가 비즈니스 모델의 수익성을 저해할 수 있는 리스크로 작용할 수 있음을 반드시 고려해야 합니다.
관련 뉴스
댓글
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.