AI 모델 (LLM·GPT·Claude·Gemini)
GPT, Claude, Gemini, Llama 등 AI 모델(LLM) 출시·벤치마크·API 변경사항을 모읍니다.
최신 업데이트
AI 모델 관련 글 — 416 페이지
- 0
Ensu: Ente의 로컬 LLM 앱
Ente는 빅테크 기업에 의존하지 않는 개인 정보 보호와 통제를 강조하며 오프라인에서 구동되는 로컬 LLM 앱 'Ensu'를 출시했습니다. 이 앱은 완전히 기기 내에서 작동하여 프라이버시를 보장하며, 향후 E2EE 동기화 및 백업 기능을 통해 더욱 개인화된 AI 경험을 제공할 예정입니다. Ensu는 아직 초기 단계이지만, Ente는 과거 로컬 얼굴 인식 기술 성공 사례를 바탕으로 로컬 LLM의 '충분한 역량' 임계점 도달 가능성을 믿고 있습니다.
Ensu – Ente’s Local LLM app↗ente.com
- 1
ARC-AGI-3은 AI 에이전트의 인간과 유사한 지능을 측정하기 위해 고안된 새로운 인터랙티브 추론 벤치마크입니다. 이는 정적인 퍼즐 해결을 넘어, 에이전트가 새로운 환경에서 지속적으로 학습하고, 경험을 통해 적응하며, 목표를 효율적으로 달성하는 능력을 평가합니다. 궁극적으로 인간 학습과 AI 학습 간의 격차를 수량화하여 범용 인공지능(AGI) 개발을 촉진하는 데 중점을 둡니다.
ARC-AGI-3은 AI 에이전트의 인간과 유사한 지능을 측정하기 위해 고안된 새로운 인터랙티브 추론 벤치마크입니다. 이는 정적인 퍼즐 해결을 넘어, 에이전트가 새로운 환경에서 지속적으로 학습하고, 경험을 통해 적응하며, 목표를 효율적으로 달성하는 능력을 평가합니다. 궁극적으로 인간 학습과 AI 학습 간의 격차를 수량화하여 범용 인공지능(AGI) 개발을 촉진하는 데 중점을 둡니다.
ARC-AGI-3↗arcprize.org
- 2
Claude Skills, Plugins, Agent Teams, Cowork 완벽 분석
클로드(Claude)의 AI 기능은 '스킬(Skills)'의 단순한 재사용 가능한 기능부터 외부 데이터에 접근하는 '플러그인(Plugins)', 여러 AI가 협업하는 '에이전트 팀(Agent Teams)', 그리고 복잡한 비즈니스 워크플로우를 자동화하는 '코워크(Cowork)'까지 점진적으로 발전합니다. 이 글은 각 기능의 특징과 적용 시점을 실제 예시를 통해 설명하며, AI 활용의 복잡도 증가에 따른 유기적 연동 방안을 제시합니다.
Claude Skills, Plugins, Agent Teams, and Cowork demystified.↗dev.to
- 3
Google, 새로운 AI 메모리 압축 알고리즘 TurboQuant 공개… 인터넷은 'Pied Piper'라 부른다
구글이 AI 추론(inference) 시 작업 메모리(KV 캐시)를 최대 6배까지 줄이는 새로운 AI 메모리 압축 알고리즘 'TurboQuant'를 공개했습니다. 이 기술은 성능 저하 없이 AI 실행 비용을 대폭 절감하고 효율을 극대화하여, HBO 드라마 '실리콘 밸리'의 압축 기술 'Pied Piper'에 비유되며 큰 기대를 모으고 있습니다. 현재는 연구실 단계의 기술이지만, AI 운영 비용 절감에 큰 영향을 미칠 잠재력을 가집니다.
Google unveils TurboQuant, a new AI memory compression algorithm — and yes, the internet is calling it ‘Pied Piper’↗techcrunch.com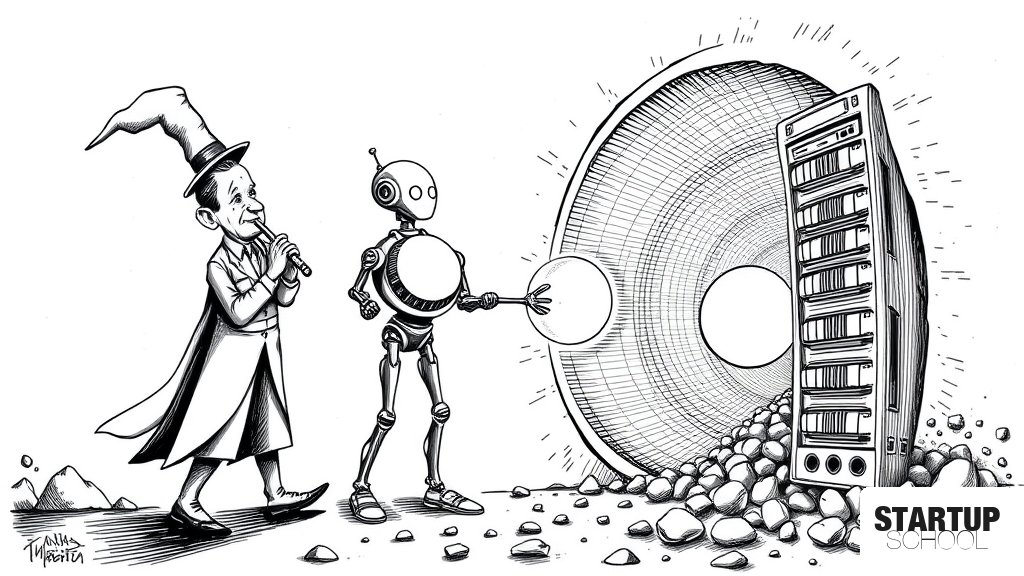
- 4
Google, Lyria 3 Pro 음악 생성 모델 출시
구글이 음악 생성 모델 '리리아 3 프로(Lyria 3 Pro)'를 출시하며, 기존 30초에서 최대 3분 길이의 트랙 생성을 지원합니다. 이 모델은 사용자에게 향상된 창작 제어 기능과 더불어 인트로, 벌스, 코러스 등 세부 트랙 구조를 이해하여 정교한 음악 생성을 가능하게 합니다. 리리아 3 프로는 제미니(Gemini) 앱 유료 구독자 및 구글 비즈(Google Vids), 프로듀서AI(ProducerAI), 그리고 버텍스AI(Vertex AI) 등 구글의 다양한 앱과 엔터프라이즈 도구에 통합될 예정입니다.
Google launches Lyria 3 Pro music generation model↗techcrunch.com
- 9
생산 최적화 — Inference 비용 및 성능 제어
이 글은 LLM 기반 고객 서비스 시스템에서 추론 비용과 성능 문제를 해결하기 위한 3단계 최적화 아키텍처를 제시합니다. 이 아키텍처는 이중 레이어 시맨틱 캐싱, 계층형 모델 라우팅, 그리고 시나리오 인식 프롬프트 압축을 통해 비용을 획기적으로 절감하고 성능을 향상시키면서도 답변 품질을 유지하는 방법을 설명합니다. 특히 70% 이상의 반복 쿼리를 캐싱으로 처리하여 불필요한 LLM 호출을 제거하는 데 중점을 둡니다.
Production Optimization: Inference Cost and Performance Control↗dev.to
- 14
[릴리즈 노트] AI가 직접 컴퓨터 조작, 오픈AI GPT-5.4 출시
오픈AI가 코딩 및 추론 능력을 통합한 프론티어 모델 GPT-5.4를 공개하며 AI가 직접 데스크톱 환경을 조작하는 네이티브 컴퓨터 사용 기능을 최초로 선보였습니다. 100만 토큰 컨텍스트 윈도우와 효율적인 Tool Search 기능으로 개발자 에이전트 구축에 최적화된 성능을 제공, AI의 자율성과 활용 범위를 혁신적으로 확장합니다. 이는 금융 및 전문 사무 업무 성능 향상과 함께 API 효율을 극대화할 것으로 기대됩니다.
요즘IT↗yozm.wishket.com
- 15
[릴리즈 노트] 역대 최강 소형 모델, 오픈AI GPT-5.4 mini·nano 출시
오픈AI가 GPT-5.4의 성능을 경량화한 소형 모델 GPT-5.4 mini와 nano를 동시 출시했습니다. mini는 기존 모델 대비 2배 이상 빠르면서도 풀 모델에 근접한 성능을 제공하며 ChatGPT, API, Codex에서 사용 가능합니다. nano는 오픈AI 라인업 중 가장 저렴하며 분류, 데이터 추출 등 특정 작업에 최적화되어 API 전용으로 제공됩니다. 이는 비용 효율성과 특정 목적에 맞는 AI 활용을 가속화할 전망입니다.
요즘IT↗yozm.wishket.com
- 16
Mamba-3는 추론 효율성을 최우선 목표로 설계된 새로운 상태 공간 모델(SSM)입니다. 기존 Mamba-2가 학습 속도에 집중한 것과 달리, Mamba-3는 더 풍부한 재귀 공식, 복소수 값 상태 추적, 그리고 정확도를 높이는 MIMO 변형을 통해 추론 성능을 대폭 개선했습니다. 그 결과, Llama-3.2-1B (1.5B 규모)를 포함한 기존 모델들을 모든 시퀀스 길이에서 사전 채우기 및 디코딩 지연 시간 면에서 능가합니다.
Mamba-3는 추론 효율성을 최우선 목표로 설계된 새로운 상태 공간 모델(SSM)입니다. 기존 Mamba-2가 학습 속도에 집중한 것과 달리, Mamba-3는 더 풍부한 재귀 공식, 복소수 값 상태 추적, 그리고 정확도를 높이는 MIMO 변형을 통해 추론 성능을 대폭 개선했습니다. 그 결과, Llama-3.2-1B (1.5B 규모)를 포함한 기존 모델들을 모든 시퀀스 길이에서 사전 채우기 및 디코딩 지연 시간 면에서 능가합니다.
Mamba-3↗together.ai
- 17
프로덕션 등급 GraphRAG Data Pipeline: PDF Parsing부터 Knowledge Graph까지 엔드 투 엔드 구축
이 기사는 지능형 고객 서비스에서 정형 및 비정형 하이브리드 데이터 처리의 한계를 극복하기 위한 프로덕션 등급 데이터 파이프라인 구축을 다룹니다. Neo4j를 통한 구조화된 지식 그래프, MinerU + LitServe를 통한 멀티모달 PDF 파싱, Microsoft GraphRAG를 통한 비정형 데이터 색인 기술을 통합하여 통일된 검색 및 조정을 목표로 합니다. 이는 기존 RAG 솔루션의 한계를 넘어 엔터프라이즈급 LLM 시스템의 핵심 난제를 해결하는 중요한 진전입니다.
# Production-Grade GraphRAG Data Pipeline: End-to-End Construction from PDF Parsing to Knowledge Graph↗dev.to
- 20
더 저렴한 LLM 제공업체로 전환 시 발생하는 'Retry Tax' 현상 (이거 나만 모르는 건가?)
많은 스타트업이 저렴한 LLM으로 전환 시 직면하는 'Retry Tax'는 토큰당 비용만 보고 선택할 경우 실제 절감 효과가 줄어드는 현상입니다. 저렴한 모델은 실패율이 높아 재시도가 많아지면서 총 API 호출 비용이 예상보다 증가하며, 이는 겉으로 보이는 비용 절감률보다 훨씬 낮은 실제 절감률을 초래합니다. 필자는 중요도에 따라 GPT와 딥시크를 혼합 사용하는 하이브리드 접근법을 통해 효율을 극대화할 것을 제안합니다.
The "Retry Tax" thing when switching to cheaper LLM providers (am I crazy or does nobody talk about this?) - I will not promote↗reddit.com
- 21
Gemini 작업 자동화는 느리고 투박하지만 엄청나게 인상적이다
구글 Gemini의 새로운 작업 자동화 기능이 픽셀 10 프로와 갤럭시 S26 울트라에서 테스트되고 있습니다. 이 기능은 느리고 투박하지만(저녁 식사 주문에 9분 소요) AI가 실제 앱을 스스로 조작하며 작업을 수행하는 첫 사례로, 미래의 AI 비서가 나아갈 방향을 보여주며 매우 인상적입니다. 이 기술은 AI가 단순한 대화를 넘어 실제 앱을 제어하여 사용자의 태스크를 완료하는 새로운 시대를 예고합니다.
Gemini task automation is slow, clunky, and super impressive↗theverge.com
- 23
MiniMax-M2.7은 스스로 진화하는 인공지능 모델로, 자율 에이전트 구동을 목표로 개발되었습니다. 이는 기존의 고정된 AI 모델을 넘어, 실시간으로 학습하고 적응하는 차세대 AI 기술의 등장을 알리는 중요한 소식입니다.
Product Hunt에 소개된 MiniMax-M2.7은 스스로 진화하는 인공지능 모델로, 자율 에이전트 구동을 목표로 합니다. 이는 단순히 지시를 따르는 것을 넘어, 환경과 상호작용하며 학습하고 최적화하는 AI 시스템의 등장을 알립니다. 이 기술은 다양한 산업 분야에서 자동화와 효율성을 혁신할 잠재력을 지니고 있습니다.
MiniMax-M2.7↗producthunt.com